
PyCologne Treffen September 2026
Datum: Mi, 09.09.2026, 19:00 Uhr Ort: Cologne Game Lab, Schanzenstraße 28, 51063 Köln (Anfahrt)
Das Treffen fand ersatzweise im Cologne Game Lab statt.
Zusammenfassung
1. Rahmen des Abends
Nach einer Vorstellungsrunde folgten zwei Beiträge: ein angekündigter Code-Deep-Dive von Andreas und ein spontaner Beitrag zum Thema Übergabe von KI-Arbeit als Sphinx-Dokumentation. Auffällig war, dass viele neue Gesichter dabei waren und der Abend dadurch deutlich interaktiver verlief als sonst: Der Vortrag wurde immer wieder für grundlegende Fragen unterbrochen, die dann in der Runde beantwortet wurden.
2. Hauptbeitrag: Kontoauszüge klassifizieren mit Textual und scikit-learn (Andreas)
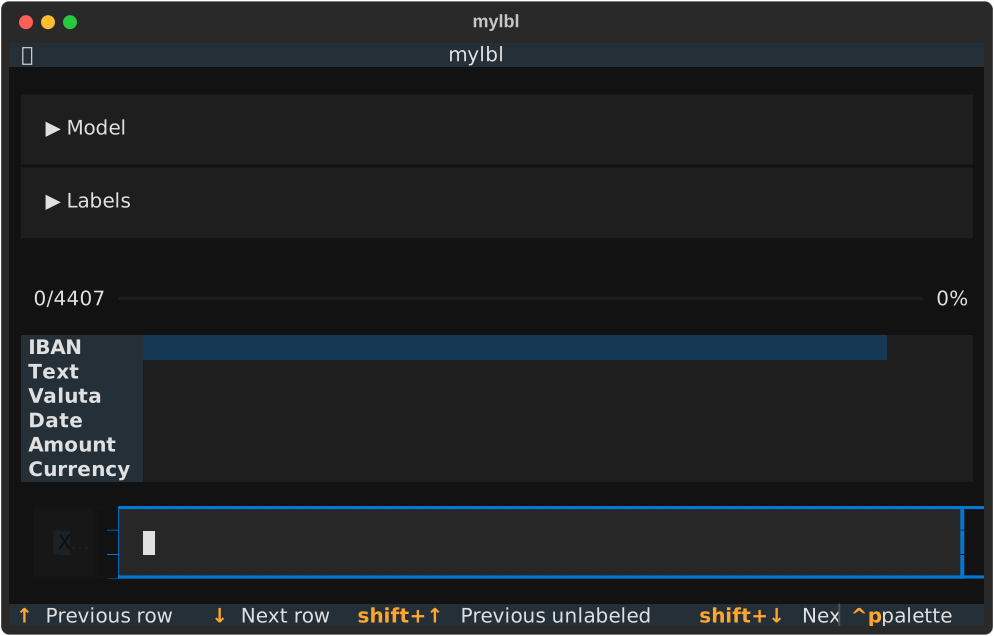
Andreas zeigte kein fertiges Produkt, sondern ging direkt in den Code seiner eigenen Anwendung. Die Ausgangsfrage war eine private: Wie kategorisiert man seine Ausgaben, ohne einer Banking-App Zugriff auf das Konto zu geben? Ergebnis ist ein Terminal-Programm, mit dem er inzwischen rund 4.000 Buchungszeilen ab 2012 kategorisiert hat. Veröffentlichen will er den Code, sobald die letzten fehlenden Features drin sind.
- CLI und Daten: Kommandozeile mit Typer, ein State-File hält den gesamten bisherigen Stand und lässt sich später um neue Auszüge erweitern. Der CSV-Export der Bank bringt die üblichen Widrigkeiten mit: keine Kopfzeile, Latin-1 statt UTF-8, umgekehrte Sortierung, und zwischen alten und neuen Auszügen wechselt sogar das Trennzeichen.
- Terminal-UI mit Textual: Widgets werden in
compose()peryielderzeugt und bilden einen Baum ähnlich einem DOM, Layout und Styling laufen CSS-artig, Container wieHorizontalwerden als Context Manager gesetzt. Das Rendering ist reaktiv: Es genügt, die Daten eines Table-Widgets zu ändern. Andreas verglich das mit Vue oder React und hielt fest, dass man für kleine Werkzeuge damit schneller ans Ziel kommt als mit einem Web-Frontend. Nebenbei: Die Demo lief über Mosh auf seinem Heimrechner, weil dessen lokale Vorhersage der Eingaben das Terminal flüssiger macht. - Grundlagen aus der Runde: Aus den Zwischenfragen entstand eine kleine
Tour durch das Ökosystem — was ein Virtual Env ist und wie es sich von
Docker unterscheidet (nur Python, keine Netzwerk- oder
Dateisystem-Isolation), wie sich pipenv, Poetry, uv und pyenv zueinander
verhalten, was
yieldaus einer Funktion macht und wozuwithals Context Manager gut ist. Auch die durchgehenden Type Hints in den 926 selbst geschriebenen Zeilen wurden diskutiert. - Support Vector Classifier: Andreas erklärte das Verfahren von Grund auf: Gesucht wird die Hyperebene, die zwei Klassen mit maximalem Abstand trennt; die nächstgelegenen Punkte sind die namensgebenden Supportvektoren. Der große Vorteil hier ist die Gleichgültigkeit gegenüber der Dimensionalität — mehr Spalten als Zeilen sind für ein statistisches Modell das Ende, für eine SVM kein Problem. Mehrere Klassen werden über One-vs-Rest abgebildet. Dafür liefert sie im Gegensatz zu statistischen Modellen keine Aussage darüber, ob der Einfluss einer Spalte signifikant ist, sondern nur die Vorhersage.
- Feature-Extraktion mit der Brechstange: Alle Spalten werden als Text
behandelt, auch Beträge und Datum, und in Zeichen-Zweiergruppen mit ihrer
Häufigkeit zerlegt (
HashingVectorizerimColumnTransformer, alles in einer scikit-learn-Pipeline). Das ergibt eine sehr breite Tabelle, was der SVM egal ist. Schön sichtbar wurde die Kehrseite: Das Modell greift sich irgendeine trennende Zeichenkombination, nicht die semantisch sinnvolle, weshalb die Accuracy mit wachsendem Datensatz zunächst wieder sinkt. - Training im Hintergrund: Nach je zehn neuen oder korrigierten
Kategorien trainiert ein Thread neu, angestoßen über ein
threading.Event; Callables für Start und Ende erzeugen die Benachrichtigungen in der UI. Daraus wurde ein längerer Exkurs über den GIL, den Unterschied zwischen concurrent und parallel und die Frage, wo hier tatsächlich eine Race Condition entstehen kann. Für 4.000 Zeilen braucht das Training einige Sekunden und etwa 10 GB RAM — der einzige Punkt, der Andreas selbst stört. - Statt Label die Distanz: Die Anwendung holt sich nicht die fertige
Vorhersage, sondern über
decision_functionden Abstand zur Hyperebene. Dadurch sieht man je Buchung, wie sicher sich das Modell ist und welche Kategorie als nächste in Frage käme. Dazu kommen Autocomplete für die Kategorienamen und eine Übersicht, wie oft jedes Label vergeben ist.
3. Diskussion rund um Buchhaltung und Datenformate
- Ein Teilnehmer hat etwas sehr Ähnliches privat gebaut, dort mit logistischer Regression, und sortiert die offenen Buchungen nach Konfidenz, um zuerst die eindeutigen abzuräumen.
- Über die Bankdaten hinaus kam die Idee auf, den Volltext der Belege mitzuspeichern und mit dem Original-PDF zu verlinken, um später etwa nach einzelnen Bauteilen suchen oder die Belege mit neuerer Technik (MuPDF) noch einmal auswerten zu können.
- Wiederkehrendes Ärgernis: Die Banken ändern ihre Exportformate über die Jahre. Der eigentliche Aufwand bei Datenprojekten steckt selten im Modell, sondern im Normalisieren über Jahrzehnte hinweg — bis zurück zu Bankleitzahlen und D-Mark.
- Erwähnt wurden GnuCash und die Plaintext-Accounting-Systeme sowie ERPNext mit dem Python-Framework Frappé (und dem schlankeren Frappé Books) als Open-Source-Alternative im ERP-Umfeld. Von dort führte ein Seitenstrang zum Restricted Python aus dem Zope-Umfeld, das an Bedeutung gewinnt, wenn ein LLM Code erzeugt, der anschließend ausgeführt wird und eben nicht auf das Dateisystem durchgreifen soll.
4. Spontaner Beitrag: Übergabe von KI-Arbeit als Sphinx-Dokumentation
Der zweite Beitrag drehte sich um ein praktisches Problem beim Arbeiten mit KI: Wie bekommt man das, was in einer langen Session entstanden ist, wieder heraus — für ein Team, für die nächste Session oder für den Wechsel zu einem anderen Modell?
- Der Handoff-Prompt: Zuerst soll das Modell wiedergeben, was es verstanden hat, statt sofort loszulaufen. Dann „answer always in handoff mode": Alles so aufbereiten, dass es in ein leeres System wieder eingespeist werden kann.
- Das Zielformat: Sphinx mit MyST-Markdown-Erweiterungen und
Furo-Theme — also die Ausdrucksmöglichkeiten von reStructuredText in
Markdown, mit Navigation, Seiten-Inhaltsverzeichnis und Volltextsuche.
Verlangt wird ein vollständiges Repo mit README,
pyproject.toml,conf.py, Build-Befehl und Auto-Build-Server für die Live-Vorschau, ausdrücklich ohne altmodischerequirements.txtund komplett per uv als One-Liner installierbar. Wenn das Ergebnis nicht passt, bekommt das Modell einfach ein Repo als Vorlage, in dem es schon so gemacht ist. - Der Rückweg: Das fertige Repo lässt sich als ZIP in die nächste Session werfen. Eine Sphinx-Doku im Kontext liest ein Modell deutlich besser als eine Webseite, und README samt Konfiguration liegen gleich mit dabei.
- Zwei Beispiele: einmal die Kommunikation für die Plone-Konferenz in Maastricht, bei der aus zwei Essays zehn LinkedIn-Posts entstehen sollten, einmal die Steuerung eines Astronautentrainers mit Mechanik, Sensorik und Servomotor-Controller, inklusive offener Punkte, Testaufbau, Simulation ohne angeschlossene Hardware und Changelog.
- Nebenbei zur Effizienz: Große Quellen vorher eindampfen — Eine Dokumentation lag als mehrere hundert MB großes HTML Archiv vor und wurde erst einmal auf den tatsächlich benötigten Umfang reduziert. Und in der Sphinx Repository-Philosophie steht der Satz, der die Richtung vorgibt: „Goal is long-term maintainability rather than cleverness."
5. Diskussion: Lesbarkeit, Sprachen und KI
Aus dem One-Liner-Thema entwickelte sich die Grundsatzfrage des Abends: Wenn Code zunehmend von der KI geschrieben und immer seltener von Menschen gelesen wird — trägt dann das Hauptargument für Python, seine Lesbarkeit, überhaupt noch? Werden Hochsprachen wieder von maschinennäheren Sprachen abgelöst?
- Dagegen sprach: Gut lesbarer Code ist die Dokumentation dessen, was er soll. Aus Maschinencode lässt sich zwar das Wie zurückgewinnen, nicht aber der Zweck. Und man liest weit mehr Code, als man schreibt.
- Alan Kays Gedanke der domänenspezifischen Sprache kam auf, ebenso das Bild von Sprache als Werkzeug, das sich nach den Anwendungsfällen formt.
- Die eigentliche Bremse sind die Trainingsdaten: Eine neu erfundene Sprache wäre für ein Modell nicht produktiv nutzbar. Umgekehrt profitieren Sprachen, für die genug Material existiert — mehrere sahen Rust dadurch noch einmal deutlich im Aufwind.
- Der Schritt zurück passiert schon: Shell-Pipelines mit awk, sed und grep, für die man von Hand einen Tag bräuchte, kommen aus dem Modell fertig heraus — und funktionieren auch auf einer Kiste ohne Netz.
- Und die Kehrseite: Wenn eine KI ein komplettes Release auf einmal ausschüttet, fehlt genau das schrittweise Verständnis, für das agiles Entwickeln einmal angetreten war. Zugleich berichtete eine Teilnehmerin von einer Projektleiterin ohne technischen Hintergrund, die ihre Anforderungen einfach als Text formuliert hat und zehn Minuten später eine funktionierende App hatte.
6. Organisatorisches
Zum Schluss ging es um die Gruppe selbst: PyCologne trifft sich seit 13 Jahren am zweiten Mittwoch im Monat, der bewusst so gewählt ist, dass er nie auf die Feiertage um den Jahreswechsel fällt. Erzählt wurde auch die Geschichte des alten Meetup-Accounts, der nach einem Krankheitsfall auslief, und des englischsprachigen Formats, das Kolleginnen und Kollegen von REWE Online daraufhin ins Leben riefen und das inzwischen ruht. Für LinkedIn entstand ein Gruppenfoto. Und es blieb der Aufruf, den auch dieser Abend wieder bestätigt hat: Wer etwas zeigen möchte, geht einfach nach vorne.
Wir suchen Themen! Wenn Du einen Vortrag halten, eine Demo zeigen oder einen Programmpunkt anmelden möchtest, melde Dich gerne. Auch für spontane Buch- oder Tool-Vorstellungen, Fragen und Coding-Ankündigungen ist Platz, bring einfach mit, was Dich gerade beschäftigt.
Anmeldung läuft unverbindlich und kostenlos über Meetup.